Электронная подпись, полученная в Казахстане, работает в Узбекистане. IT-компании не приходится заново проходить одни и те же процедуры при выходе в Кыргызстан или Таджикистан. Правила работы с данными становятся совместимыми, а для искусственного интеллекта появляются общие этические принципы. Пока это не реальность, а сценарий, который бизнес и эксперты Центральной Азии предлагают превратить в региональную цифровую повестку.
28 сентября в Астане представители бизнес-ассоциаций стран Центральной Азии, предприниматели, IT- и AI-эксперты и представители государственного сектора обсудили, пожалуй, один из самых амбициозных вопросов для технологического развития региона: может ли Центральная Азия постепенно превратиться из пяти отдельных цифровых юрисдикций в совместимое пространство для технологий и бизнеса?
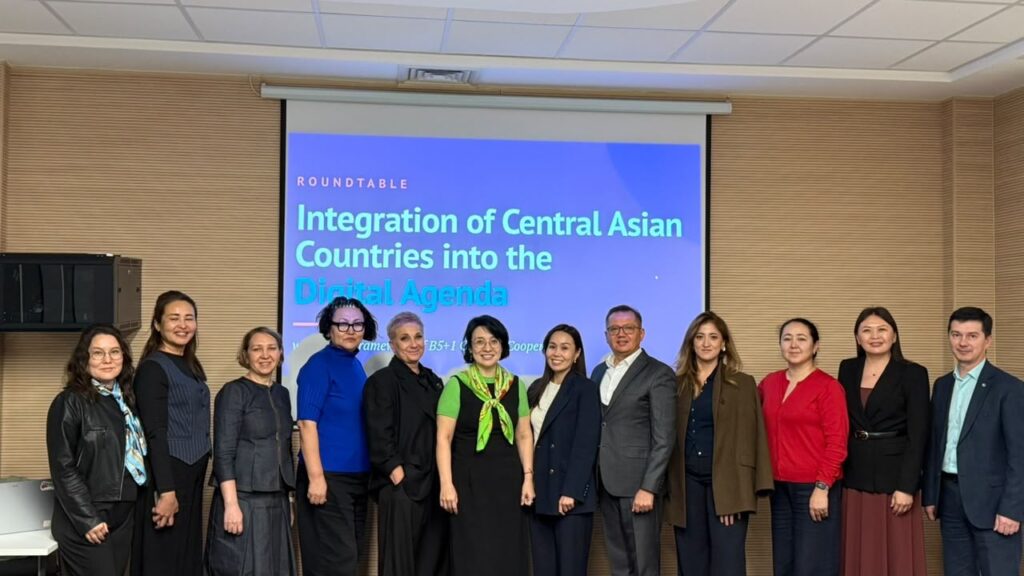
Круглый стол «Интеграция стран Центральной Азии в цифровую повестку» пройшел в рамках B5+1 Cycle III. На нем Региональная рабочая группа IT & AI представит предложения в Региональную деловую повестку на 2027 год, а также два документа, способных задать практическую рамку этой интеграции: проект межправительственного Соглашения о сотрудничестве в области цифровой политики и управления искусственным интеллектом и проект Регионального кодекса этики AI.
И здесь речь идет не столько о красивой концепции «цифровой Центральной Азии», сколько о вполне приземленных проблемах технологического бизнеса.
Пять стран — пять наборов правил
Представим казахстанский стартап, который успешно запустил продукт дома и решил выйти сразу на несколько рынков Центральной Азии.
Ему приходится разбираться с новыми правилами идентификации, электронными подписями, требованиями к данным, договорам, регистрации и другим цифровым процедурам. То, что юридически и технически работает в одной стране, не обязательно будет признано в соседней.
Для крупной корпорации это дополнительные расходы. Для небольшого стартапа они могут стать причиной вообще отказаться от региональной экспансии.
Именно поэтому в основе новой региональной повестки лежит достаточно прагматичный вопрос: что нужно изменить, чтобы технологическая компания, созданная в одной стране Центральной Азии, могла значительно проще масштабироваться на весь регион?
Региональная рабочая группа IT & AI предлагает несколько направлений — от взаимного признания электронной цифровой подписи до совместимых правил работы с данными и общего подхода к AI.
В предыдущем цикле консультационный процесс охватил бизнес-сообщества, представляющие более 60 предприятий и организаций Центральной Азии и США, включая Meta, Mastercard, Google и Uber, а также региональные филиалы AmCham в странах ЦА.
ЭЦП как первый тест цифровой интеграции
Одно из наиболее конкретных предложений — взаимное признание электронных цифровых подписей и других инструментов цифровой идентификации.
На первый взгляд, это техническая тема. На практике она затрагивает фундаментальный вопрос: сможет ли предприниматель из одной страны полноценно совершать юридически значимые цифровые действия в другой.
Проект межправительственного соглашения предусматривает сближение подходов к электронным документам, электронной подписи и цифровой идентификации. В перспективе стороны смогут определять условия их взаимного признания на основе сопоставимых требований надежности и безопасности. При этом создавать одну общую для пяти стран систему цифровой идентификации не предлагается.
В этом и заключается ключевая философия инициативы.
Центральной Азии не нужны пять одинаковых цифровых законодательств. Нужно, чтобы пять систем научились понимать друг друга.
Данные должны пересекать границы вместе с бизнесом
Второй большой вопрос — данные. Современная цифровая компания практически неизбежно сталкивается с облачными сервисами, персональными данными, трансграничной передачей информации и требованиями к ее хранению.
Поэтому рабочая группа предлагает двигаться к большей совместимости правил трансграничной передачи и защиты данных, локализации, cloud-инфраструктуры и дата-центров.
В проекте межправительственного соглашения предусмотрена возможность выработки механизмов взаимного признания достаточности защиты персональных данных или других правовых механизмов для их законной и безопасной трансграничной передачи.
Для бизнеса предсказуемость здесь не менее важна, чем сама либерализация: компания должна заранее понимать, где она может хранить данные, как их передавать и какие требования действуют на соседнем рынке.
А что делать с AI?
Если с электронной подписью и данными государства уже накопили значительный опыт регулирования, то искусственный интеллект ставит перед регионом совершенно новые вопросы. Кто отвечает, если AI ошибся?Обязан ли человек знать, что решение в отношении него было подготовлено алгоритмом?
Можно ли полностью автоматизировать решение о кредите, трудоустройстве или доступе к услуге? Нужно ли маркировать AI-контент в ЦА? И где заканчивается полезная автоматизация и начинается недопустимое вмешательство в права человека?
Ответить на эти вопросы предлагается в Кодексе этики ответственного использования искусственного интеллекта в Центральной Азии.
Человек — выше алгоритма
Самая интересная идея проекта Кодекса звучит просто: искусственный интеллект может помогать принимать решения, но ответственность должна оставаться у человека. Если AI используется для юридически значимого решения, оно не должно основываться исключительно на заключении алгоритма. Окончательное решение должен принимать человек. Более того, предусматривается возможность вмешаться в работу системы, остановить ее или отменить полученный результат.
Пользователь также должен знать, что взаимодействует именно с AI, и иметь возможность получить понятное объяснение результата. При этом разработчику не придется раскрывать исходный код, параметры модели или коммерческую тайну.
Получается довольно интересный баланс: не тормозить технологию регулированием, но сохранить за человеком право понимать и оспаривать решения машины.
У AI появится «красная зона»
В проекте есть и перечень практик, которые предлагается считать неприемлемым региональным минимумом.Например, AI не должен использоваться для вредоносного манипулирования поведением человека, эксплуатации уязвимости детей и других групп, дискриминационной биометрической классификации или обработки незаконно полученных персональных данных. Отдельно упоминается синтетический контент — использование deepfake и других AI-материалов для мошенничества, причинения вреда или дискредитации. При этом Кодекс задуман не как еще один жесткий регуляторный слой. Он носит рекомендательный характер, не создает наднационального органа и не вводит обязательную региональную сертификацию AI.
Но есть еще одна проблема: AI плохо знает нас
Для Центральной Азии вопрос искусственного интеллекта имеет особое измерение — язык. Большинство глобальных моделей значительно лучше обучены на английском других языках с огромными массивами цифровых данных. Чем меньше язык представлен в интернете и обучающих датасетах, тем сложнее добиться сопоставимого качества AI. Поэтому в региональном Кодексе появляется необычный для подобных документов пункт: развитие языковых ресурсов и наборов данных для языков Центральной Азии.
AI-системы, работающие с населением, должны учитывать языковое многообразие пользователей, а качество услуги не должно зависеть от языка обращения. Фактически речь идет уже не только об этике, но и о будущем цифровой субъектности региона. Если Центральная Азия хочет не просто пользоваться чужими AI-моделями, ей нужны собственные качественные данные на казахском, узбекском, кыргызском, таджикском, туркменском и других языках.
Шесть пунктов для цифрового рынка Центральной Азии
В Региональную деловую повестку B5+1 на 2027 год рабочая группа предлагает вынести шесть практических направлений: взаимное признание ЭЦП и цифровой идентификации; совместимость правил трансграничной работы с данными и цифровой инфраструктурой; усиление и сближение защиты интеллектуальной собственности в IT; общий региональный подход к AI governance и этике; постоянный государственно-частный диалог по цифровому регулированию; системную работу с глобальными технологическими компаниями и инвесторами.
Последний пункт особенно важен. Для Meta, Microsoft, Google, Amazon, глобальных cloud-провайдеров или технологических инвесторов каждая отдельная страна Центральной Азии — относительно небольшой рынок. Но логика может измениться, если регион начнет восприниматься как более интегрированное пространство с населением свыше 80 миллионов человек.
Именно поэтому цифровая интеграция становится уже не только технологическим, но и инвестиционным вопросом.
Не «цифровой Евросоюз»
Важно, что авторы инициативы не предлагают создавать центральноазиатский аналог единого наднационального цифрового законодательства. Проект соглашения прямо говорит: речь не идет ни об унификации законодательства, ни о передаче полномочий наднациональному регулятору. Каждая страна сохраняет право самостоятельно определять свою цифровую политику.
Формула гораздо осторожнее:
- совместимость вместо унификации;
- взаимное признание вместо повторных процедур;
- общие принципы вместо единого регулятора.
Если эта модель заработает, IT-компании смогут тратить меньше ресурсов на преодоление пяти разных административных систем и больше — на продукт, технологии и масштабирование.
Следующий этап — от разговоров к пилотам
Именно поэтому встреча 28 сентября важна не самим фактом очередного обсуждения цифровизации. На круглом столе за одним столом окажутся бизнес-ассоциации Центральной Азии, предприниматели, IT- и AI-эксперты и представители государственных органов. Им предстоит понять, какие идеи уже достаточно зрелые, чтобы двигаться от концепции к практической реализации. Потенциальным тестом может стать взаимное признание цифровых инструментов. Другим — согласование подходов к AI. Третьим — механизм постоянного диалога бизнеса с государствами при разработке цифрового регулирования.
В конечном счете главный вопрос звучит еще проще.
Сможет ли стартап, родившийся в Астане, Ташкенте, Бишкеке, Душанбе или Ашхабаде, однажды воспринимать Центральную Азию как свой домашний рынок? Если ответ будет положительным, это изменит не только правила работы IT-бизнеса. Это изменит сам масштаб технологических амбиций региона.